Los agentes de IA van a matar el "exportar a Excel", no tus dashboards
En LinkedIn se discute si la IA va a matar al dashboard. Es la pregunta equivocada: los agentes de IA cambian el trabajo de quien usa los datos y del equipo de BI. Qué funciona, qué no y qué no sabemos.


Todos los dashboards tienen un botón que los equipos de datos odiamos: "Exportar a Excel".
Lo odiamos porque es una confesión. Alguien miró el número, le pareció raro y quiso saber por qué. Quiso cruzarlo con otra cosa, ver el detalle de una región, de un cliente, de una semana. El panel no tenía la respuesta, así que exportó y se fue a hacer su propio análisis en una planilla.
- Lo que va a desaparecer no es el dashboard: es el "exportar a Excel". Los agentes de IA responden la pregunta siguiente que el panel no contempló.
- Cambia el trabajo de dos personas: quien usa los datos deja de esperar, y el equipo de datos pasa de construir reportes a definir qué significa cada número.
- Sin definiciones acordadas, el modelo no importa: el agente entrega números equivocados con total seguridad.
Cambia el trabajo de quien usa los datos, que por fin puede hacer la pregunta siguiente sin exportar nada. Y cambia el trabajo del equipo de datos, que deja de medirse por lo que construye y empieza a medirse por lo que define.
Mientras tanto, en LinkedIn la discusión va por otro lado. De una trinchera, "el dashboard murió, ahora le preguntas a la IA", la promesa de todas las campañas de "habla con tus datos". De la otra, "los dashboards nunca van a morir".
Lo digo de frente: parte de lo que hacemos nosotros es entregar información en el formato o forma que sirva para tomar decisiones (incluye los dashboards). Sería muy cómodo escribir que no mueren y quedarme tranquilo. No es eso lo que me interesa. Quiero ordenar lo que creo que está pasando, porque hay mucho ruido y poca honestidad sobre qué cambió de verdad.
Llevo quince años construyendo sistemas de datos. El año pasado partí con algunas apps vibecodeadas (armadas a punta de conversar con una IA), y desde marzo estoy full con agentes de IA, en clientes y en herramientas internas. Y como somos consultora, no vemos una sola área de datos: vemos muchas. Este año hablamos de esto con una institución financiera, una manufacturera, una agroindustrial, una cadena de retail y una compañía industrial con un equipo de analítica de primer nivel. Ninguna nos pidió lo mismo. Pero en todas apareció, de una u otra forma, esta conversación.
Lo que cambió para los equipos de datos: construir dejó de ser el cuello de botella
Este año armamos un proyecto completo (modelo de datos, capa semántica y un MCP encima) en días, con un agente de código. Una capa semántica es el acuerdo escrito de qué significa cada número, qué es una venta o un cliente activo, para que cualquier persona o agente lo calcule igual. Un MCP es el enchufe que deja a la IA leer esos datos sin que nadie se los copie a mano. Uno de mis socios tomó la misma idea y en horas tenía unos reportes funcionando sobre su propio sistema. No lo dejó en producción, pero el punto es ese:
Lo que antes era un proyecto, hoy es una tarde.
Ojo con la lectura fácil de esa frase. No es que todo ande solo. Los días fueron días porque llevábamos meses entendiendo qué es un MCP, qué hace bien una capa semántica y qué no, y qué queríamos construir. Un agente hace lo que le pides por el camino más corto. Si lo que le pediste no tiene especificaciones, ese camino va a ser el más fácil de recorrer, no el mejor para tu caso, y el resultado se va a ver igual de bien. Por eso lo que sigue tomando tiempo es escribir esas especificaciones: qué pasa si defino la métrica así, qué se rompe si cambio el grano, qué pregunta va a hacer el usuario que no estoy contemplando. Eso sigue requiriendo experiencia, y ningún agente la trae puesta.
Con esa salvedad, el cambio tiene dos consecuencias. La primera: cuando baja el costo, aparece demanda que antes no existía. Es la paradoja de Jevons (en simple: cuando algo se vuelve más barato no lo usamos menos, lo usamos muchísimo más. Cuando las fotos costaban un rollo sacábamos 24 en las vacaciones; hoy tenemos 14.000 en el celular y miramos tres) [1]. Empresas que nunca iban a contratar un proyecto de datos ahora pueden tener uno.
La segunda es menos obvia: cuando construir es barato, el valor se mueve al descubrimiento y al contexto. Lo caro ya no es el código; son los meses que toma entender los casos borde y las decisiones que nadie había tomado. Un agente no sabe qué contexto le falta, y ya vimos qué camino toma cuando falta. Si nadie decidió si una devolución resta de la venta del mes, el agente lo va a decidir por ti, y no te va a avisar.
Lo vimos en una compañía industrial con un área de analítica madura. Ahí los usuarios de negocio construyen y publican sus propios reportes con ayuda de IA, y el equipo de datos ya no arma cada uno: revisa que estén bien hechos y que respeten las definiciones. Conectaron un agente a todo el código del área, y hoy responde solo preguntas como "¿existe un reporte de inventario?". Los tickets chicos bajaron y el equipo quedó libre para hacer analítica avanzada. Pero también vimos el borde: cuando un usuario va directo a las tablas del ERP, la IA sabe qué es una venta en general, no qué es una venta en esa empresa. Eso lo sabe el equipo de datos, y no siempre está escrito.
Hay un dato que me persigue: en las últimas mediciones públicas, la adopción de BI estaba estancada en algo entre 25 % y 35 % de las personas de una empresa (Gartner, 2019; BARC y Eckerson Group, 2022) [2][3]. O sea, el problema nunca fue hacer dashboards más rápido. Es que la gente use la información para decidir (algo de eso escribimos en 6 pasos para la adopción de una estrategia de BI).
¿Qué cambia para quien usa los datos?
Vuelve al botón de "exportar a excel". Cuando la pregunta siguiente no tiene dónde ir, la gente la responde como puede. En una institución financiera con la que conversamos se notaba a simple vista: cansados de esperar, los usuarios habían armado sus propias "mini informáticas", con cientos de reportes sin documentar y cada uno con su versión de los números.
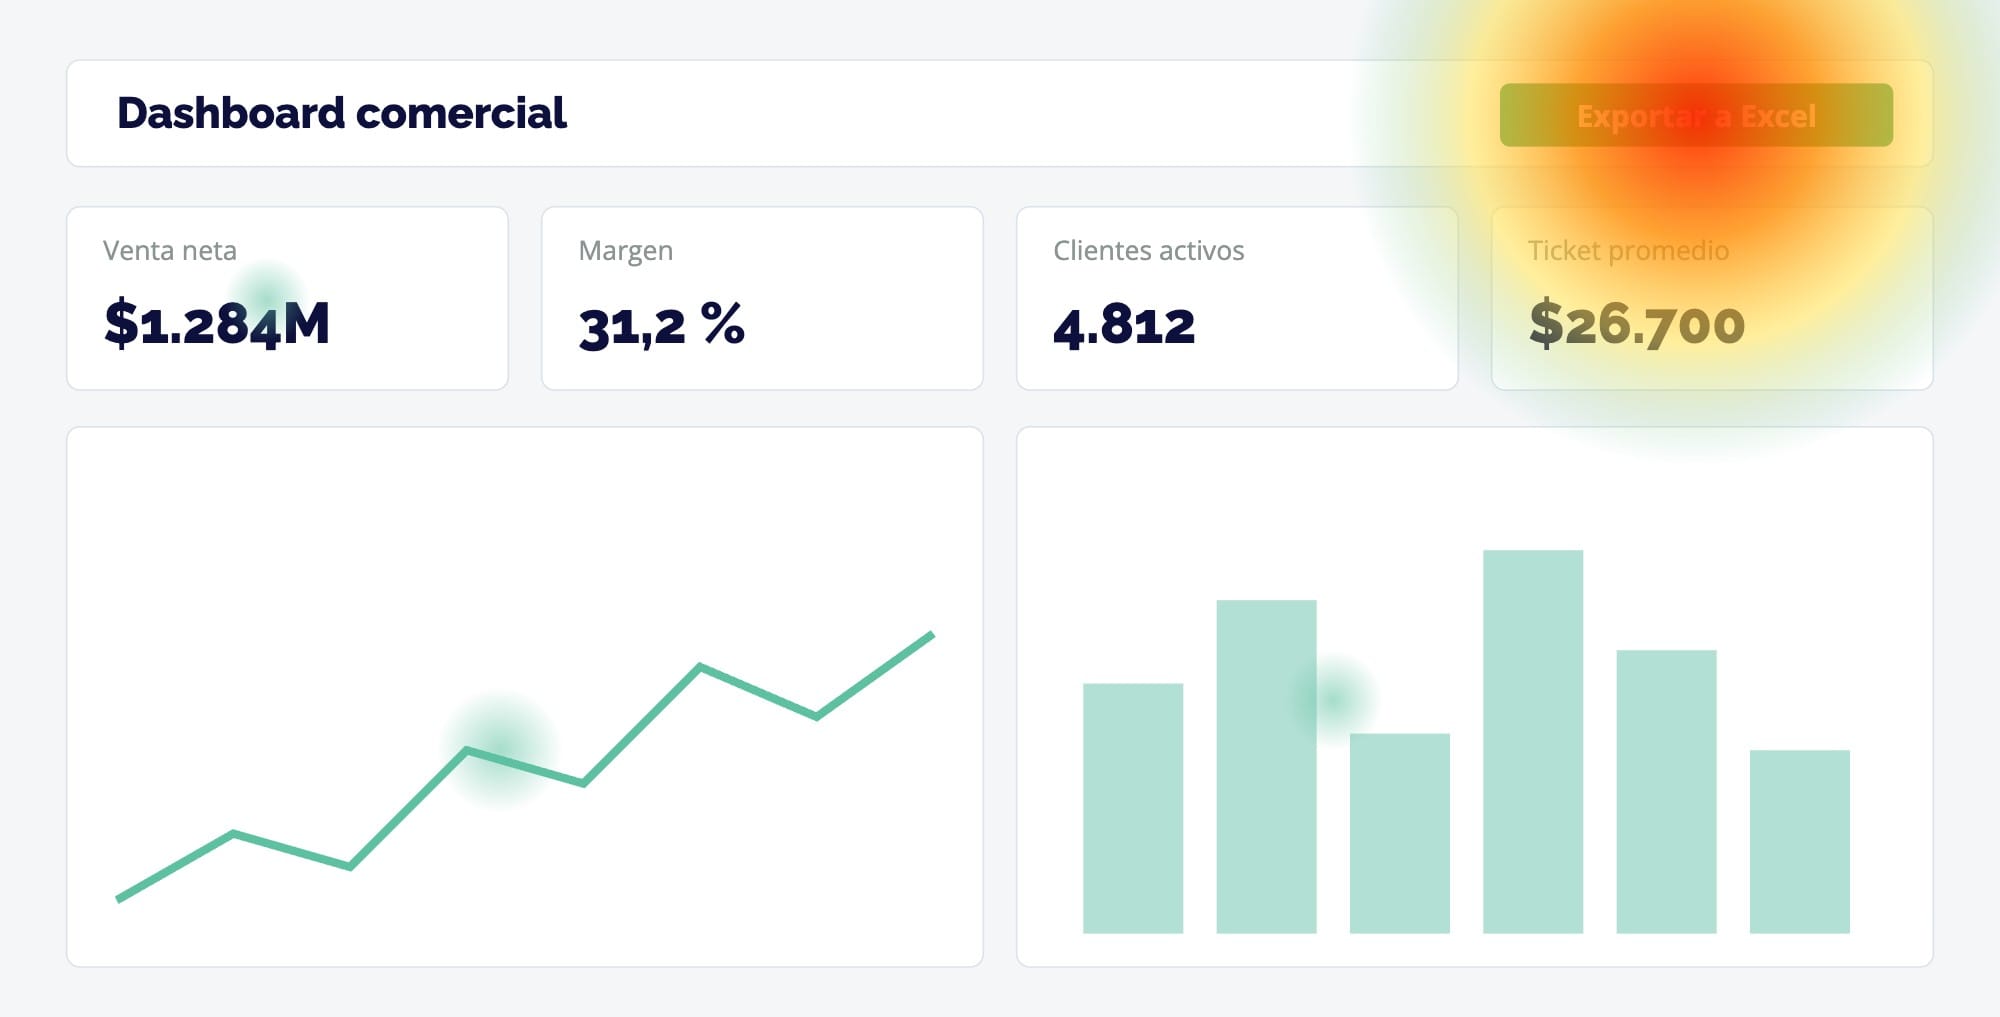
Lo que cambia con la IA es que esa pregunta ahora se le puede hacer en lenguaje natural a un agente conectado a los mismos datos del panel:
- ¿Por qué bajó esto en el sur?
- ¿Cómo se compara con el mismo trimestre del año pasado?
- ¿Qué clientes explican la caída?
En vez de exportar a Excel, le preguntas al agente.
Para mí, ese es el cambio más grande de todos. No es espectacular. No es un robot que decide solo. Es cerrar el vacío que el botón de exportar dejó abierto durante veinte años.
No es teoría. Anthropic puso un agente en el chat interno donde su gente ya trabaja, y en uno de sus canales de datos respondió más del 75 % de las preguntas del mes, en uno o dos minutos (Anthropic, 2026) [4]. Las preguntas típicas son las del botón: "¿qué explica esta caída?".
Con una empresa manufacturera estamos llevando esto a auditoría. En vez de revisar por muestreo, estamos armando un monitor que revisa el 100 % de las compras con alertas automáticas, y un agente al que preguntarle por cada caso y por sus datos de origen, sin descargar nada.
En una agroindustrial con operación en varios países, dejamos esos agentes en producción: la misma definición para cada métrica, permisos por rol y registro de quién preguntó qué.
Ahora, si el agente responde lo que el panel no, la conclusión fácil es que el panel sobra. Acá es donde me separo de las dos trincheras.
Tres opiniones impopulares
1. Lo que sobrevive no es el dashboard. Es el acuerdo
Un panel cumple una función que no es técnica, es comunicacional. Es lo que la empresa decidió mirar en conjunto: estos son los números que importan, así se calculan, así se llaman. La pantalla puede cambiar mañana por un chat, un correo o lo que venga. Lo que no puede desaparecer es ese acuerdo. Si dos gerentes le preguntan al agente "¿cuánto vendimos?" y obtienen cifras diferentes, el agente no se equivocó dos veces. La empresa nunca definió qué es vender.
Y el panel también protege al agente. Quien recibe uno o dos números sueltos por chat pierde la prueba del olfato: ver la cifra junto a su tendencia y sus métricas vecinas, y pensar "esto no puede ser" (Anthropic, 2026) [4]. Sin ese contexto, una respuesta equivocada pasa más fácil.
Si tuviera que decirlo en una frase: la IA en datos es como Google Maps. Te lleva más lejos, pero no decide adónde vas.
2. El modelo casi nunca es el problema
Hace dos años, en Spider 2.0, un benchmark con bases de datos empresariales reales, el mejor agente resolvía el 21,3 % de las tareas [5]. Hoy los mejores del ranking pasan del 75 % [6]. Los agentes ya escriben SQL bastante bien. El problema en tu empresa no es si la consulta corre, sino si "venta" significa lo mismo para todos. Con la definición equivocada, no hay error: hay un número equivocado entregado con total seguridad.
Por eso, en lo que construimos nosotros, el agente no inventa la consulta: le pide la métrica a la capa semántica y la capa la arma siempre de la misma forma. Tres o cuatro herramientas: listar métricas, consultar, graficar. Nada más.
El dato más contundente lo publicó Anthropic sobre sus propios datos: sin definiciones ni contexto codificado, Claude no pasaba del 21 % de precisión en sus evaluaciones internas. Con esa capa de conocimiento, supera el 95 % (Anthropic, 2026) [7].
Mismo modelo. Lo que cambió fue lo que había debajo.
Armamos una demo pública de esto: corre con el modelo más barato de Claude y responde bien. Cambiar de modelo no arregla un data warehouse desordenado. Y como las plataformas ya traen MCP nativo, construir el conector dejó de ser el mérito. El mérito es tener algo debajo que valga la pena conectar.
3. El usuario de esto no es el analista
El analista ya tiene acceso a los datos, sabe SQL y tiene su Excel armado. Para él, el agente es una conveniencia. El dolor lo siente el que depende de otros para obtener datos: el gerente de auditoría que le pide a TI una consulta a SAP y espera tres días, o el director que recibe una presentación y quiere un detalle que no está en ninguna lámina.
Llevo meses con esto y no quiero venderte certezas. Así que te lo ordeno como lo ordeno para mí.
¿Qué funciona, qué no y qué todavía no sabemos?
Lo que vemos funcionar
Lo que no funciona (todavía)
Una advertencia honesta: si en tu empresa nadie mira los paneles, no partas por el agente. Parte por ponerte de acuerdo en los números.
Lo que no sabemos
Durante veinte años, el botón de "Exportar a Excel" fue la forma más honesta que tenía la gente de decirnos "esto no me alcanza". Lo tratamos como un problema de los usuarios. Era un problema nuestro.
Lo que viene no es un dashboard más bonito. Es que, por primera vez, podamos contestarle a esa persona en el momento en que tiene la pregunta.
Creo que en unos años alguien va a abrir un panel, va a buscar ese botón y no lo va a encontrar. No porque alguien lo haya sacado. Porque dejó de hacer falta.
Me queda algo que todavía no sé responder. Si el usuario ya no necesita esperar al equipo de datos para la pregunta siguiente, ¿en qué va a usar ese equipo el tiempo que le sobra? Yo apuesto a que en decidir qué significa cada número. Pero puedo estar equivocado, y me interesa más tu respuesta que la mía.
Te leo en los comentarios. Y si estás justo en esa decisión, conversemos.
Pruébalo tú
Te prometí un regalo para el final. Son dos.
Un agente conversando con datos de verdad
Dos demos abiertas y gratis para ver cómo responde un agente sobre datos ordenados.
Si quieres ver cómo un agente conversa con datos de verdad, con la misma arquitectura que usamos en producción, te invito a probar las demos que armamos con datos públicos en nuestra web. Son gratis y no necesitas instalar nada: escribes la pregunta en la página y el agente responde sobre una capa semántica, mostrando qué métricas consultó para llegar a su respuesta. Y si ya tienes tu propio agente (Claude, ChatGPT, Gemini), puedes conectarlo directo.

Pregúntale, por ejemplo: cómo va el desempleo juvenil, qué región está peor o cuánto cambió la informalidad respecto del año pasado.

Pregúntale, por ejemplo: cuánto ha llovido este año en tu ciudad comparado con su promedio histórico.
Lo que importa más que el modelo
Y si quieres probar hacer esto en tu empresa, estas son las cosas que a mí me importan más que el modelo de lenguaje:
- Alcance estrecho. Partir con diez métricas bien gobernadas, no con "toda la base". Las métricas simples funcionan; las compuestas (retención por cohorte, atribución) fallan seguido.
- Preguntas doradas y evals. Un set de preguntas con respuesta conocida, en español, que se corre cada vez que algo cambia. Sin esto no sabes si el agente mejoró o empeoró; solo tienes una sensación. Anthropic midió lo que pasa si se descuida: la precisión de su agente bajó de ~95 % a ~65 % en un mes sin mantención, y hoy el 90 % de los cambios a su modelo de datos van en el mismo commit que el cambio a las instrucciones del agente [7].
- Abstención. El agente tiene que saber decir "eso no lo puedo responder con estos datos". Un agente que siempre responde es más peligroso que uno que a veces se calla.
- Humano en el loop. Nadie publica automáticamente un número de ventas a un canal de la empresa. Un número equivocado enviado solo mata la confianza para siempre.
- Mostrar la consulta. Que un analista pueda ver qué métrica y qué filtros usó el agente convierte la caja negra en algo auditable. Anthropic le pone a cada respuesta un pie de procedencia con las fuentes consultadas [7].
- Costo. La aceleración con IA sube el consumo del warehouse antes de que suba el presupuesto: en la encuesta 2026 de dbt Labs, el 57 % de los equipos reporta más gasto en cómputo y solo el 36 % más presupuesto [8]. Poner límites antes del entusiasmo, no después.
- Preparar el modelo antes de abrir el chat. La propia documentación de Copilot en Power BI lo dice: sin preparar el modelo semántico, Copilot "puede malinterpretar los datos y devolver resultados genéricos o imprecisos" [9]. Si el proveedor lo dice, créele. El chat no arregla un modelo mal documentado; lo expone.
Referencias (9)
- W. S. Jevons, The Coal Question (1865); resumen en Wikipedia.
- Gartner (2019), citado en TechTarget, BI adoption poised to break through barrier, finally. techtarget.com
- BARC y Eckerson Group, Strategies for Driving Adoption and Usage with BI and Analytics (2021-2022). barc.com
- Anthropic, Self-service data analytics in Slack (agosto de 2026). claude.com
- Lei et al., Spider 2.0: Evaluating Language Models on Real-World Enterprise Text-to-SQL Workflows (2024, ICLR 2025). arxiv.org
- Spider 2.0, ranking oficial (consultado en noviembre de 2026). spider2-sql.github.io
- Anthropic, How Anthropic enables self-service data analytics with Claude (junio de 2026). claude.com
- dbt Labs, State of Analytics Engineering 2026. getdbt.com
- Microsoft Learn, Copilot for Power BI overview, sección "Data preparation". learn.microsoft.com
Francisco Calderón
CEO y cofundador de Datalized. Ingeniero en Información y Control de Gestión de la Universidad de Chile y MBA de la UC, lleva más de 14 años en consultoría, con paso por Deloitte, Everis y Biwiser, construyendo sistemas de datos que realmente sirvan para decidir. Desde 2026 trabaja todos los días con agentes de IA sobre los datos de empresas de industrias muy distintas.
Desde 2025 hace running en serio, y es tan apasionado que armó para sí mismo lo mismo que hacemos para los clientes: un MCP sobre sus datos de Apple Health, para que el agente con el que conversa sus entrenos dejara de recibir diez capturas de pantalla por sesión. Lo contó en LinkedIn.
Preguntas frecuentes
¿Qué es una capa semántica?
Es un acuerdo escrito sobre qué significa cada número de la empresa (venta, margen, cliente activo) y cómo se calcula. Cuando una IA consulta esa capa en vez de las tablas, obtiene siempre la misma cifra para la misma pregunta.
¿Un agente de IA reemplaza a Power BI u otro dashboard?
No. El dashboard muestra lo que la empresa decidió mirar en conjunto. El agente responde las preguntas que aparecen después de mirar el panel, que antes terminaban en una planilla de Excel.
¿Qué necesita una empresa para preguntarle a la IA por sus datos?
Datos ordenados en un solo lugar, un conjunto acotado de métricas con definiciones acordadas y una capa semántica que el agente pueda consultar. Sin eso, la IA responde rápido, pero con números poco confiables.
¿Por qué la IA da números distintos para la misma pregunta?
Porque escribe una consulta nueva cada vez sobre tablas que nadie definió. Si la empresa no acordó qué es una venta, cada consulta puede contarla distinto. Una capa semántica elimina esa variación.
¿Qué es un MCP y para qué sirve en analítica?
Un MCP (Model Context Protocol) es un estándar abierto que conecta un agente de IA con los sistemas y datos de una empresa de forma controlada. En analítica, permite que el agente consulte métricas ya definidas en una capa semántica, en vez de escribir consultas a ciegas sobre las tablas.